三张照片变成 20 秒视频:Gas Station Dance 真实生成案例
完整观看未经剪辑的输出,对照三张输入照片和四个场景,了解这次 480p 单次测试证明了什么、没有证明什么。
最近更新: 2026-10-05
我们用三张虚构成年人物照片生成了下面的视频。文件长 20.04 秒,分辨率 480 × 854,带生成音频。本次没有输入原舞蹈视频,因此,这是新生成的场景,不是原视频里三张脸的替换。
播放器展示完整输出。我们没有替换音轨、加速视频,也没有从多次尝试中剪出最好看的片段。
三张输入,各自承担什么角色?
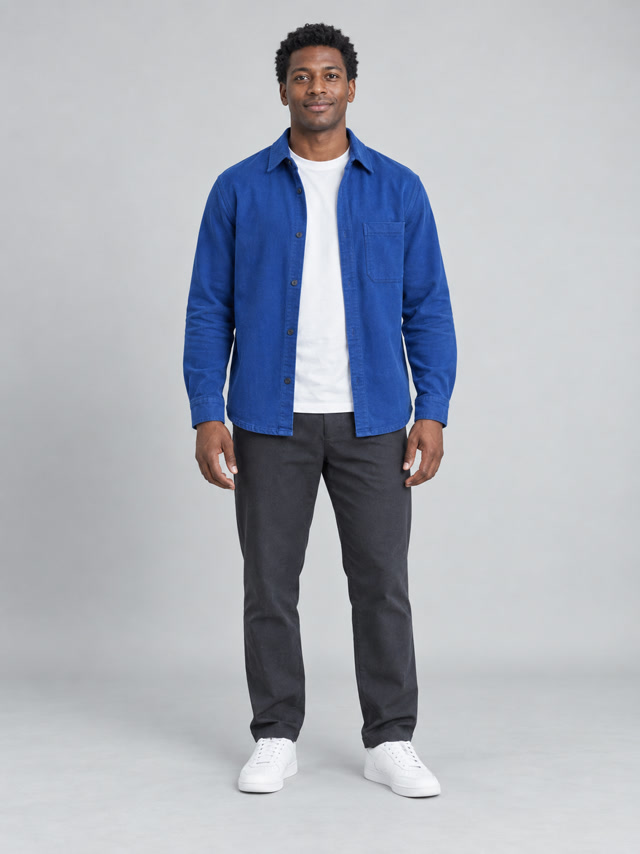
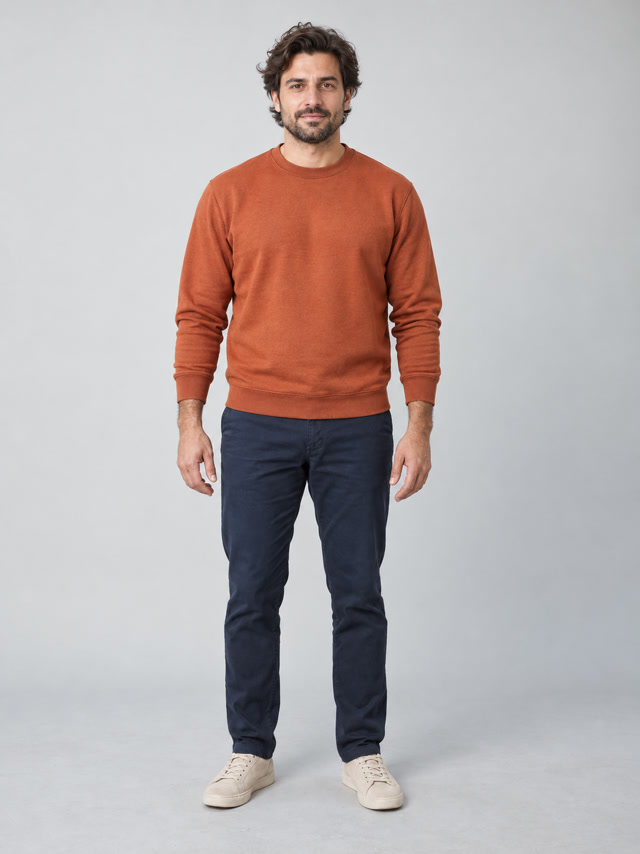
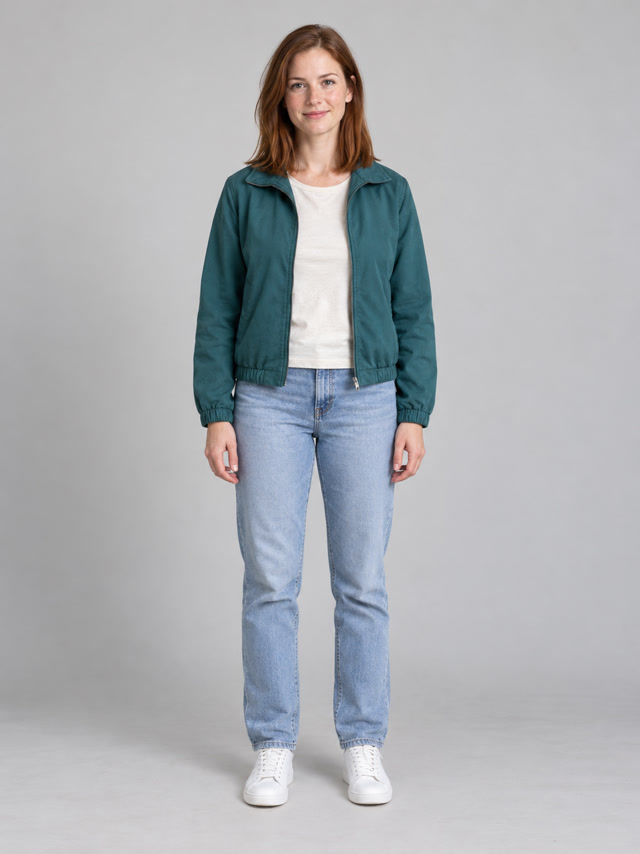
从左到右:跳舞、自拍、下车角色。图片是本次测试的实际输入,不是客户照片。
可以按衣服颜色追踪角色:蓝色外衫负责跳舞,锈红色上衣负责自拍,青绿色外套负责下车。
输出里发生了什么?
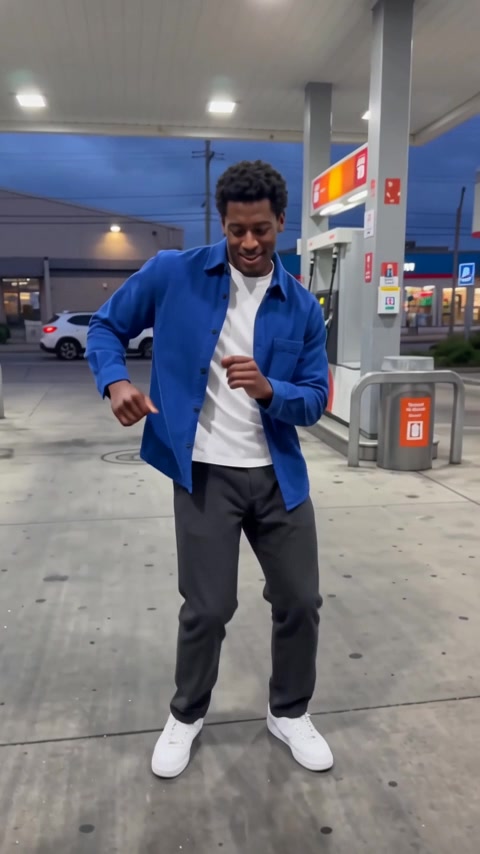
1. 开场跳舞
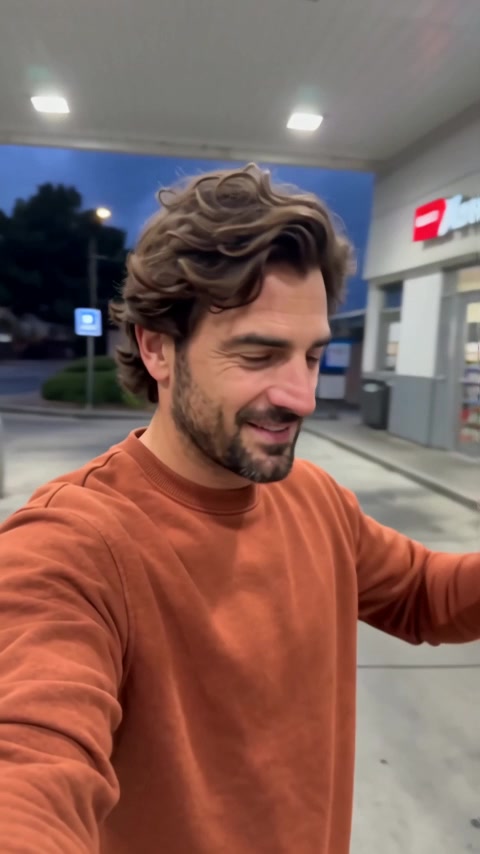
2. 转向自拍
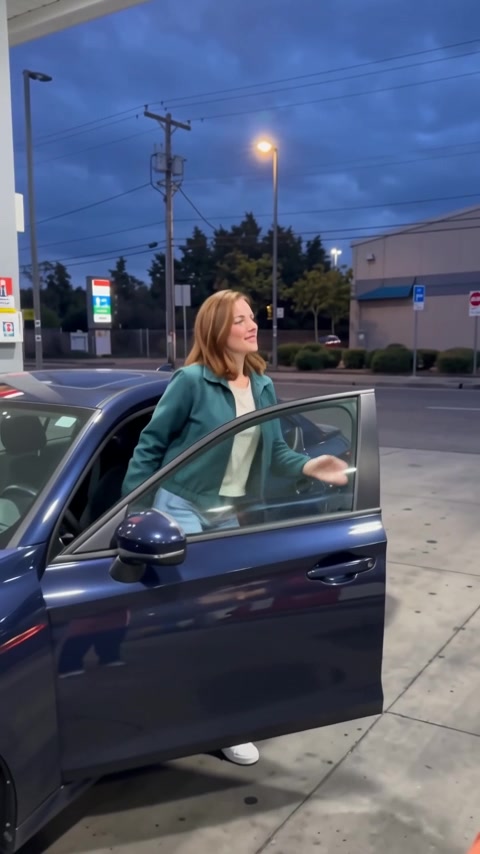
3. 下车登场
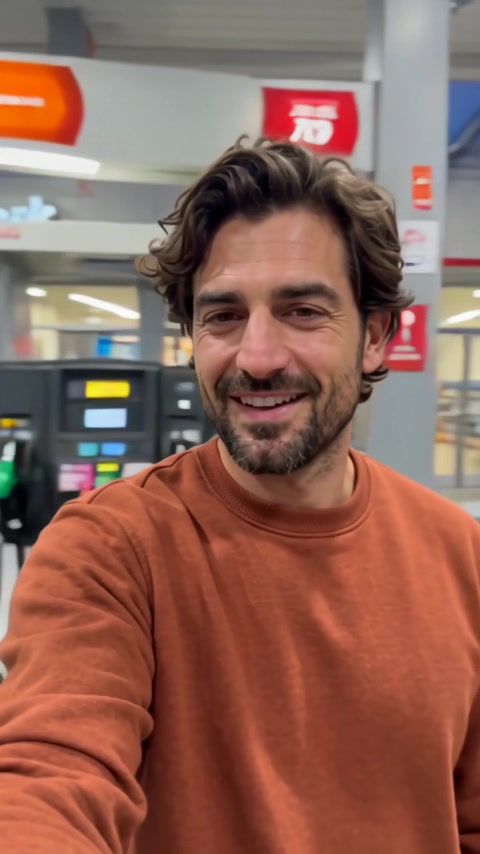
4. 回到自拍
四张截图来自同一输出文件。转场和动作应在完整视频里判断。
输出包含预期的四段顺序,蓝色外衫、锈红色上衣和青绿色外套可以作为追踪角色的线索。结尾回到了第二个自拍人物。
不过,截图不能回答所有质量问题。例如,下车截图中移动的手有模糊,是否自然要看连续动作,不能只看一个静止瞬间。脸像不像输入人物,也需要你自行比较;本次没有测量身份相似度分数。
这次是怎样生成和检查的?
真实生成于 2026 年 10 月 5 日在本地测试,使用 Kie 提供的 Wan,模型 ID 为 wan/3-0-video。请求包含三张角色照片,设置为 20 秒、480p、启用音频。只提交了一次生成,不是从批量结果中挑选。
生成后,我们在浏览器播放保存的 MP4,检查音轨,并通过结果界面下载。
技术检查与测试环境
该文件为 H.264、30 fps 视频,AAC 双声道、44.1 kHz 音频,音轨解码成功。视频生成是真实的,结账使用 Stripe 测试模式;本次未验证生产支付。
从这份样片可以期待什么?
这组照片生成了完整的四段视频,并包含生成音轨。 对照输入照片与完整视频,可以检查人物、动作和结尾。
这是一份 480p 单次生成案例,不是模型评测或成功率统计。换一组照片,结果可能不同;原舞步、原曲以及 720p、1080p 输出未在本次测试中验证。
适不适合你想做的作品?
如果你希望给朋友制作一段可以辨认三个人、采用类似故事结构的玩笑视频,可以对照完整样片判断。如果必须保留原舞蹈、原运镜和原音轨,就不要把这个案例当作已有能力的证明。